TML 推出了 stable-reinforce,SC 的作者 Martin 通过逆向工程发现其为 SC。不过 TML 还为 stable-reinforce 加了一个采样器-训练器的 KL 散度选项,该选项可以直接加到 loss 函数里。
这个 KL 项,其实是正则化。
昨天早些时候,Martin 通过把 Adam 优化器的 $ε$ 设置为 10000,成功逆向了 TML 的 stable-reinforce 梯度,最终发现 stable-reinforce 实质上采用了 top-k 的 score centering,其中 $k=8$。
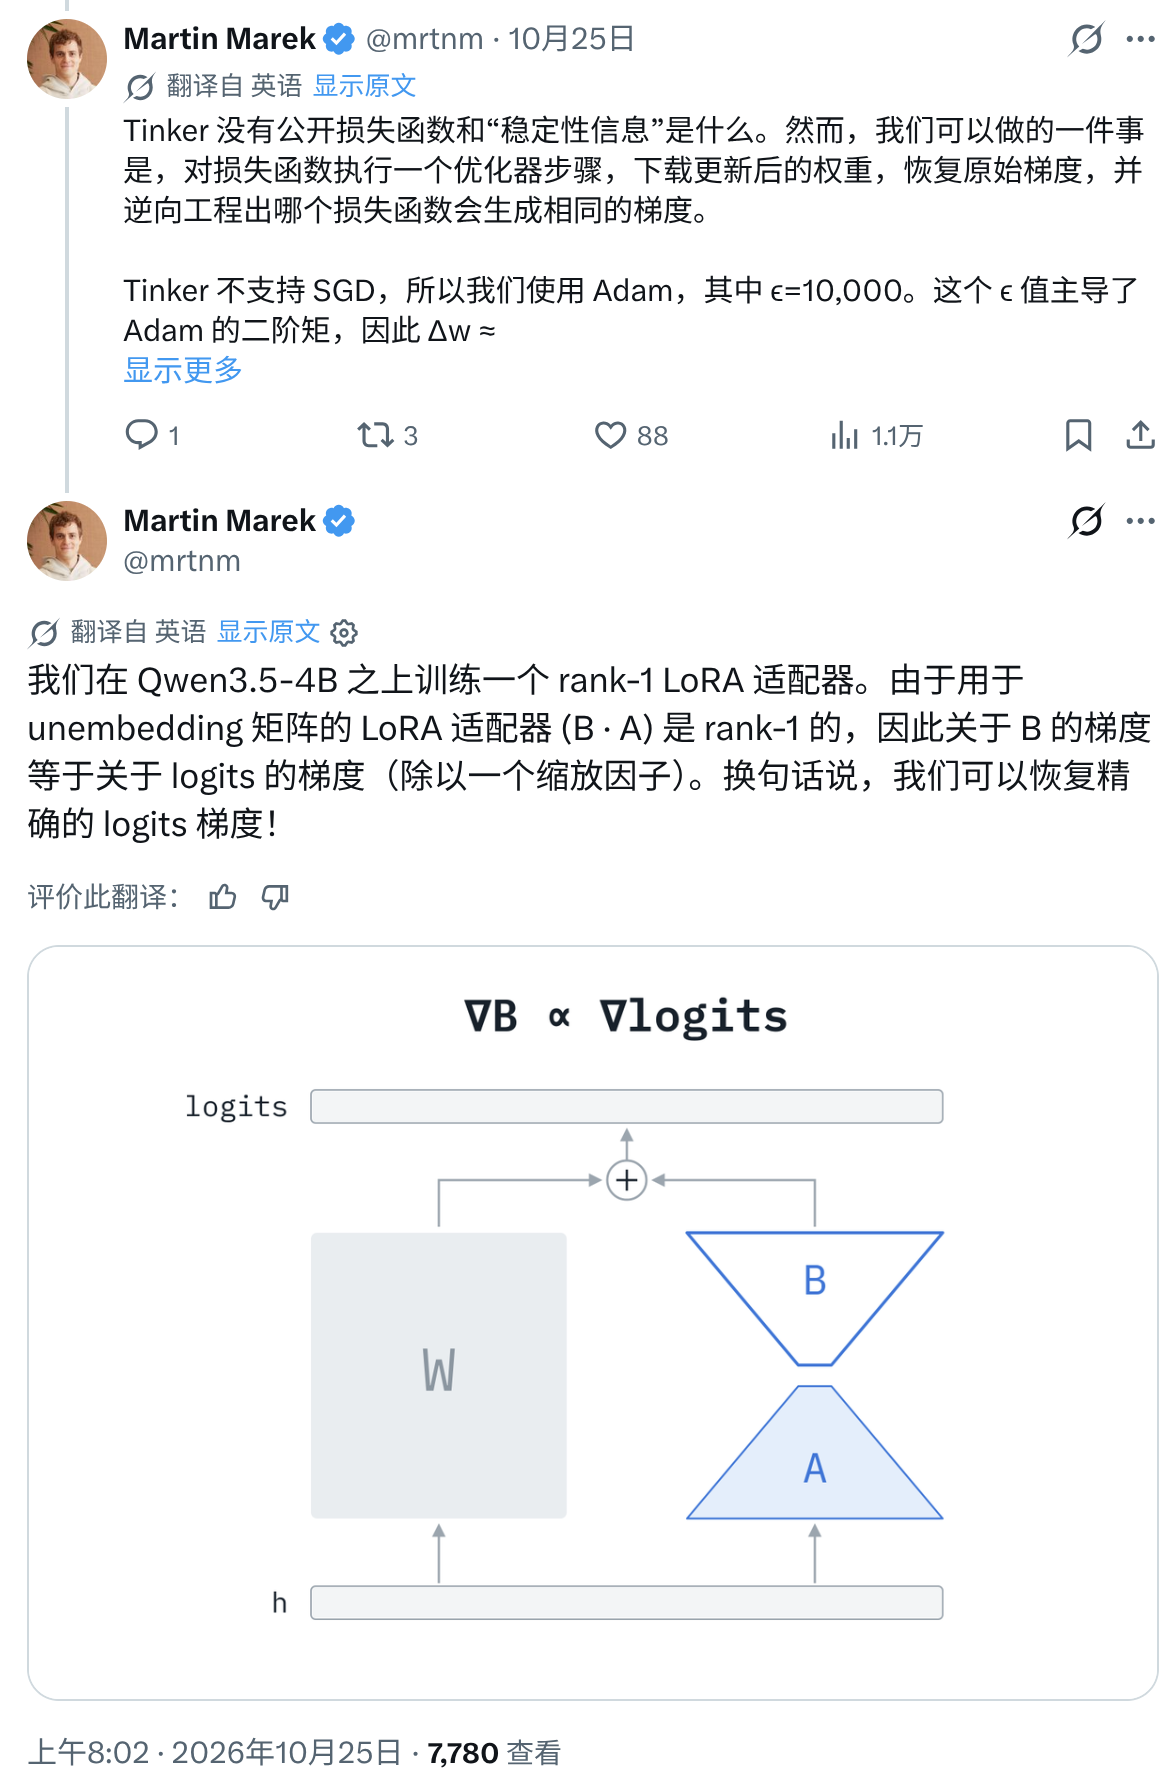
具体来说,他让 TML 帮他训练了一个 LoRA,其中秩为 1。此 LoRA 应用于 LLM 的 unembedding 矩阵,由于 $hA$ 是一个标量,所以 $B$ 在一次更新时发生的变化,就刚好是 logits 的变化的常数倍。
这就是他逆向的过程。最终,他发现 stable-reinforce 是普通 PG + top-k SC。
不过,TML 的文档中,有一个引人注意的选项:TML 可以让你(可选地)直接在 loss 函数中加一个 KL 散度项。具体来说,是 trainer 和 sampler 这两个分布之间的 KL 散度。
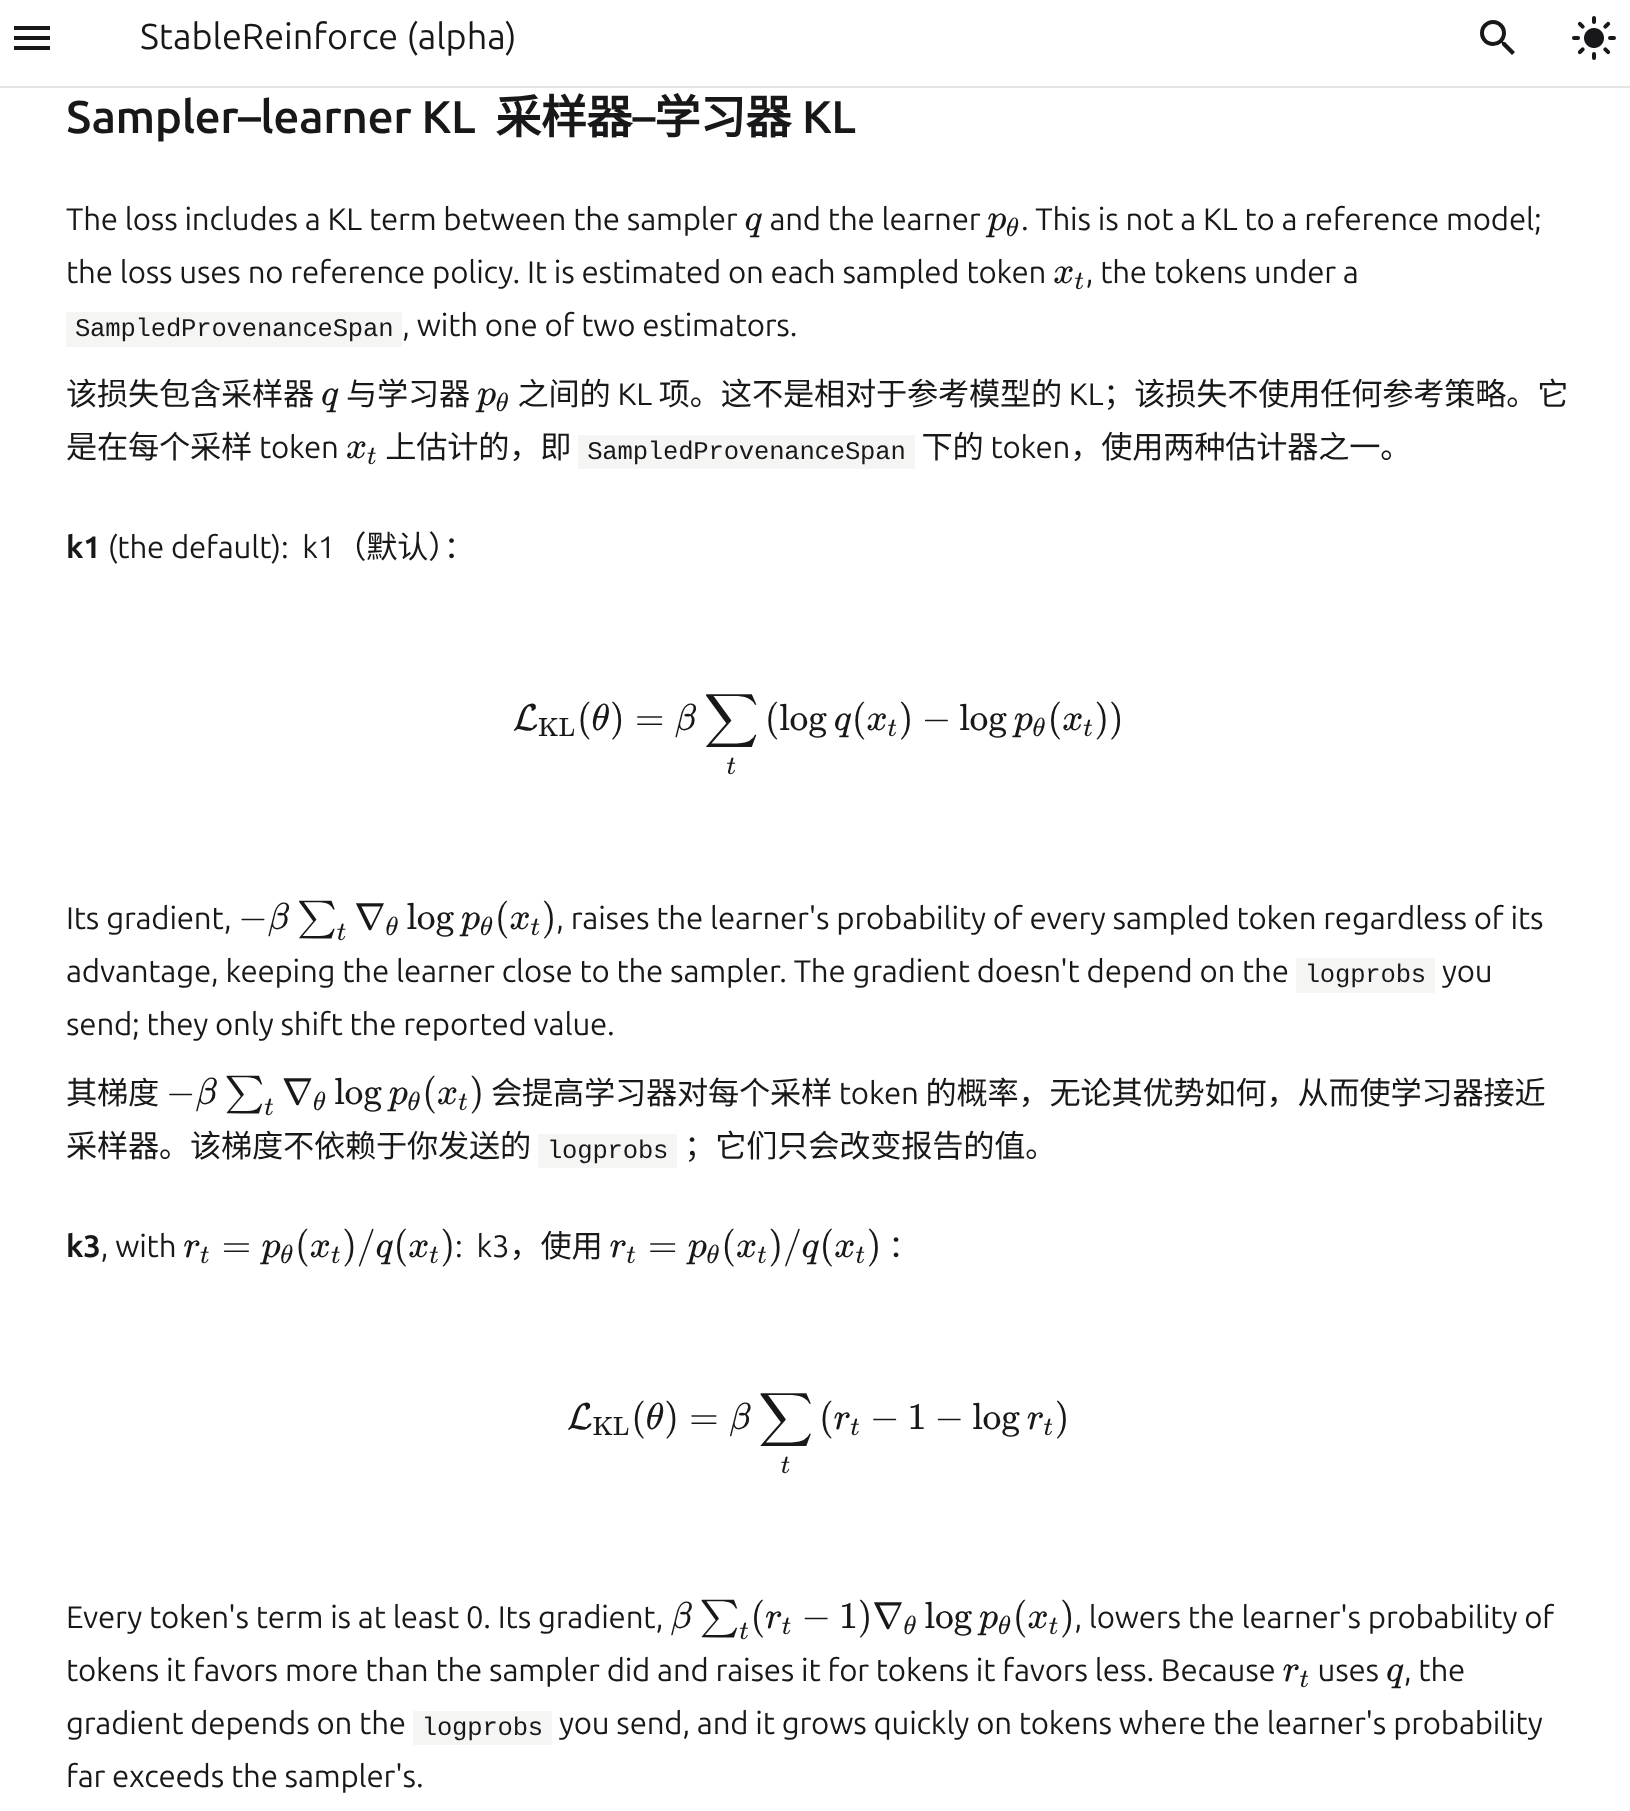
某种意义上来说,即使 SC 去掉了奖励加权的漂移,就又会被此 KL (少量地)加回来。
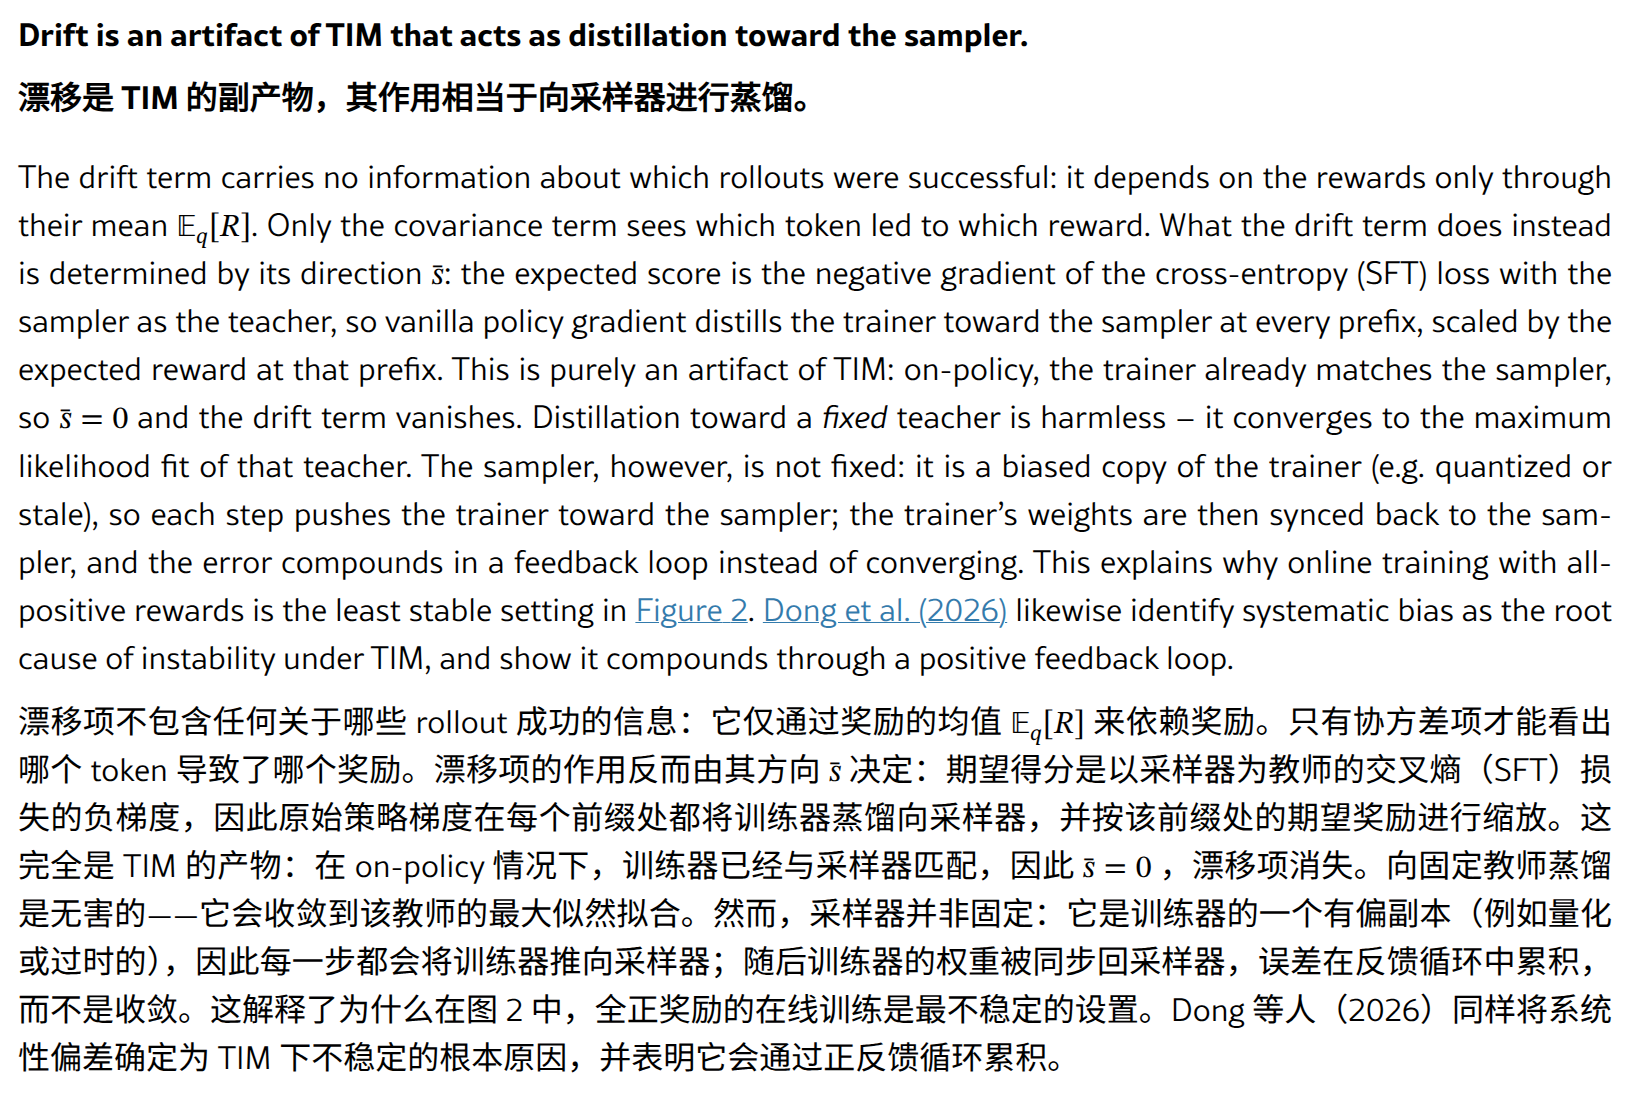
这是因为,SC 修正项对应 $-R\,D_{\mathrm{KL}}(q|p_\theta)$,为什么?毕竟 CE 与 KL 它们的梯度是一样的,而 SC 移除的 drift 可以视为 CE。论文原图:
具体来说,考虑固定前缀下的完整词表,交叉熵与 KL 满足
因此,二者对 $\theta$ 的梯度相同。再看,SC 在普通 PG loss 上加入的修正项为
而 TML 额外加入的正则项对应
所以,当 $R>0$ 时,SC 修正项与 TML 额外 KL 正则项的梯度方向相反:前者抵消奖励加权的漂移,后者以独立系数约束 trainer 不要偏离 sampler 太远。
那么,TML 为什么考虑加回去一个 $+\beta\,D_{\mathrm{KL}}(q|p_\theta)$ 呢?
网上有一些讨论得出了结论。我这里简单总结一下:KL 是一个正则项,$\beta$ 也不大,不会完全伤害漂移的去除,并且可以让 trainer 不要偏离 sampler 太远。