最近的 Score Centering 居然有整整五种解释方法🫠🫠🫠每一个角度都很有趣!
本文详细整理了五个解释 Score Centering(SC)的角度,而且每个都附上了出处链接。本文就是:「五等分的 Score Centering」。😉
TL;DR:
| 视角 | 对 SC 的解释 |
|---|---|
| 原 SC 视角 | SC 是一种解决训推不一致(TIM)导致的 drift 的方法。 |
| BPO 视角 | SC 是根据 PMD 的闭式解改写的 critic-free 目标的 token-level surrogate 的梯度。 |
| Advantage 定义视角 | SC 是人们希望得到 sampler 分布的精确 value baseline 而推出来的期望更新。 |
| STE 视角 | SC 是直通估计器(STE)。 |
| 局部分布族视角 | SC 是构造出的局部分布族在起点处的真实 score。 |
最后两个其实很接近 🤔 它们在变化靠近更新零点 $\delta=0$ 时是一样的。不过出发点不同,而且它们都特别精彩!所以我分为两点记录了。
另外,本文会记录一些关于社区的实现的笔记,如果你想快速浏览五种视角,可以直接跳过。
每一点,都能独立推出 SC,这真是异曲同工。接下来我来详细讲他们的核心。
前言:Score Centering 近况
截至 2026 年 10 月 10 日,SC 已经有 原论文、官方实现,也已经进入 verl 的 rollout correction 实现。
2026 年 9 月 17 日,Martin Marek 与 Max Ryabinin 提出 Score Centering (SC),引起广泛关注,社区迅速响应,9 月 23 日,slime 实现了 SC:PR #2405;
10 月 1 日,verl 实现了 SC:PR #8010。
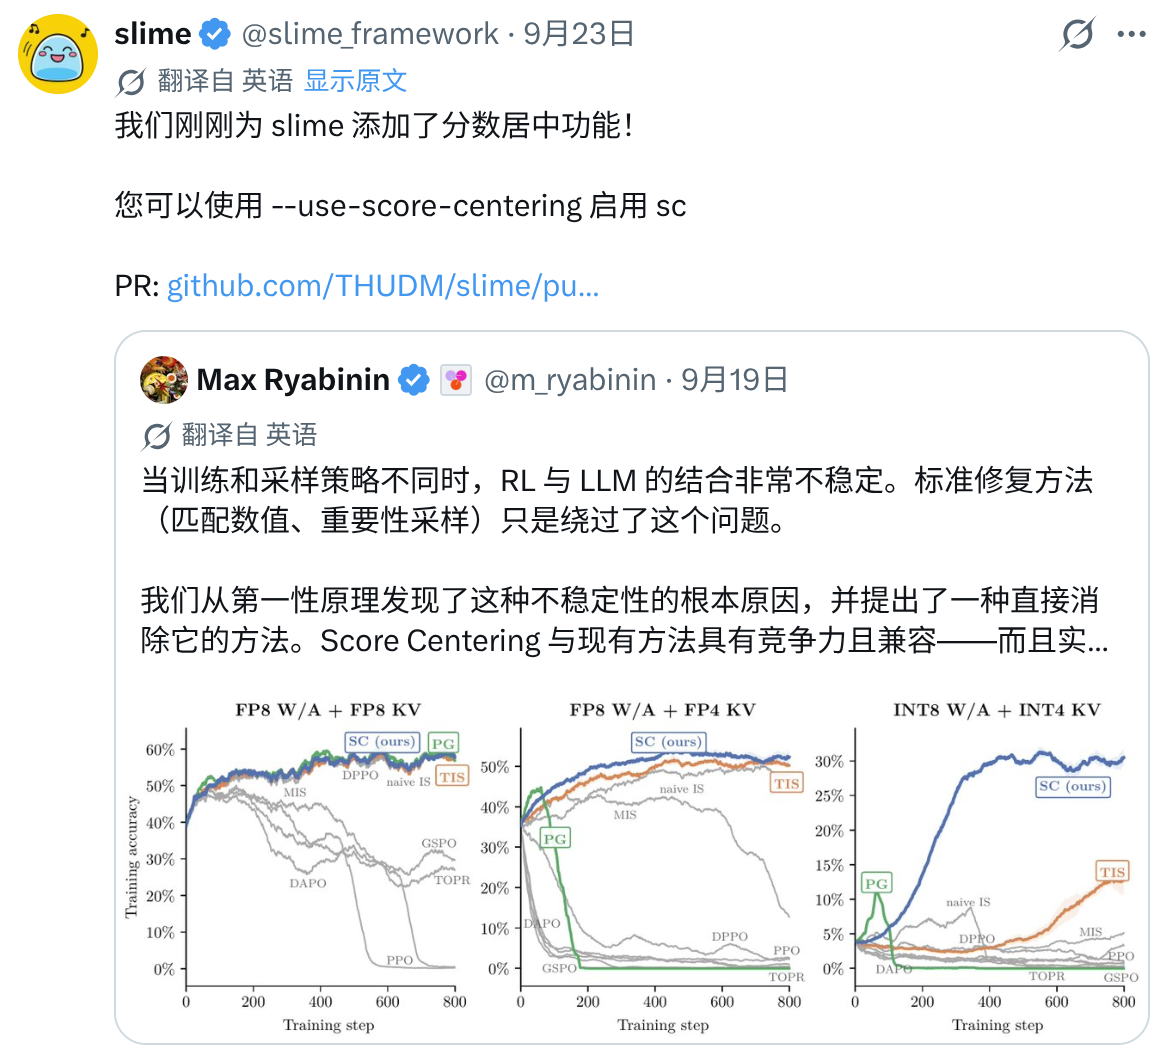
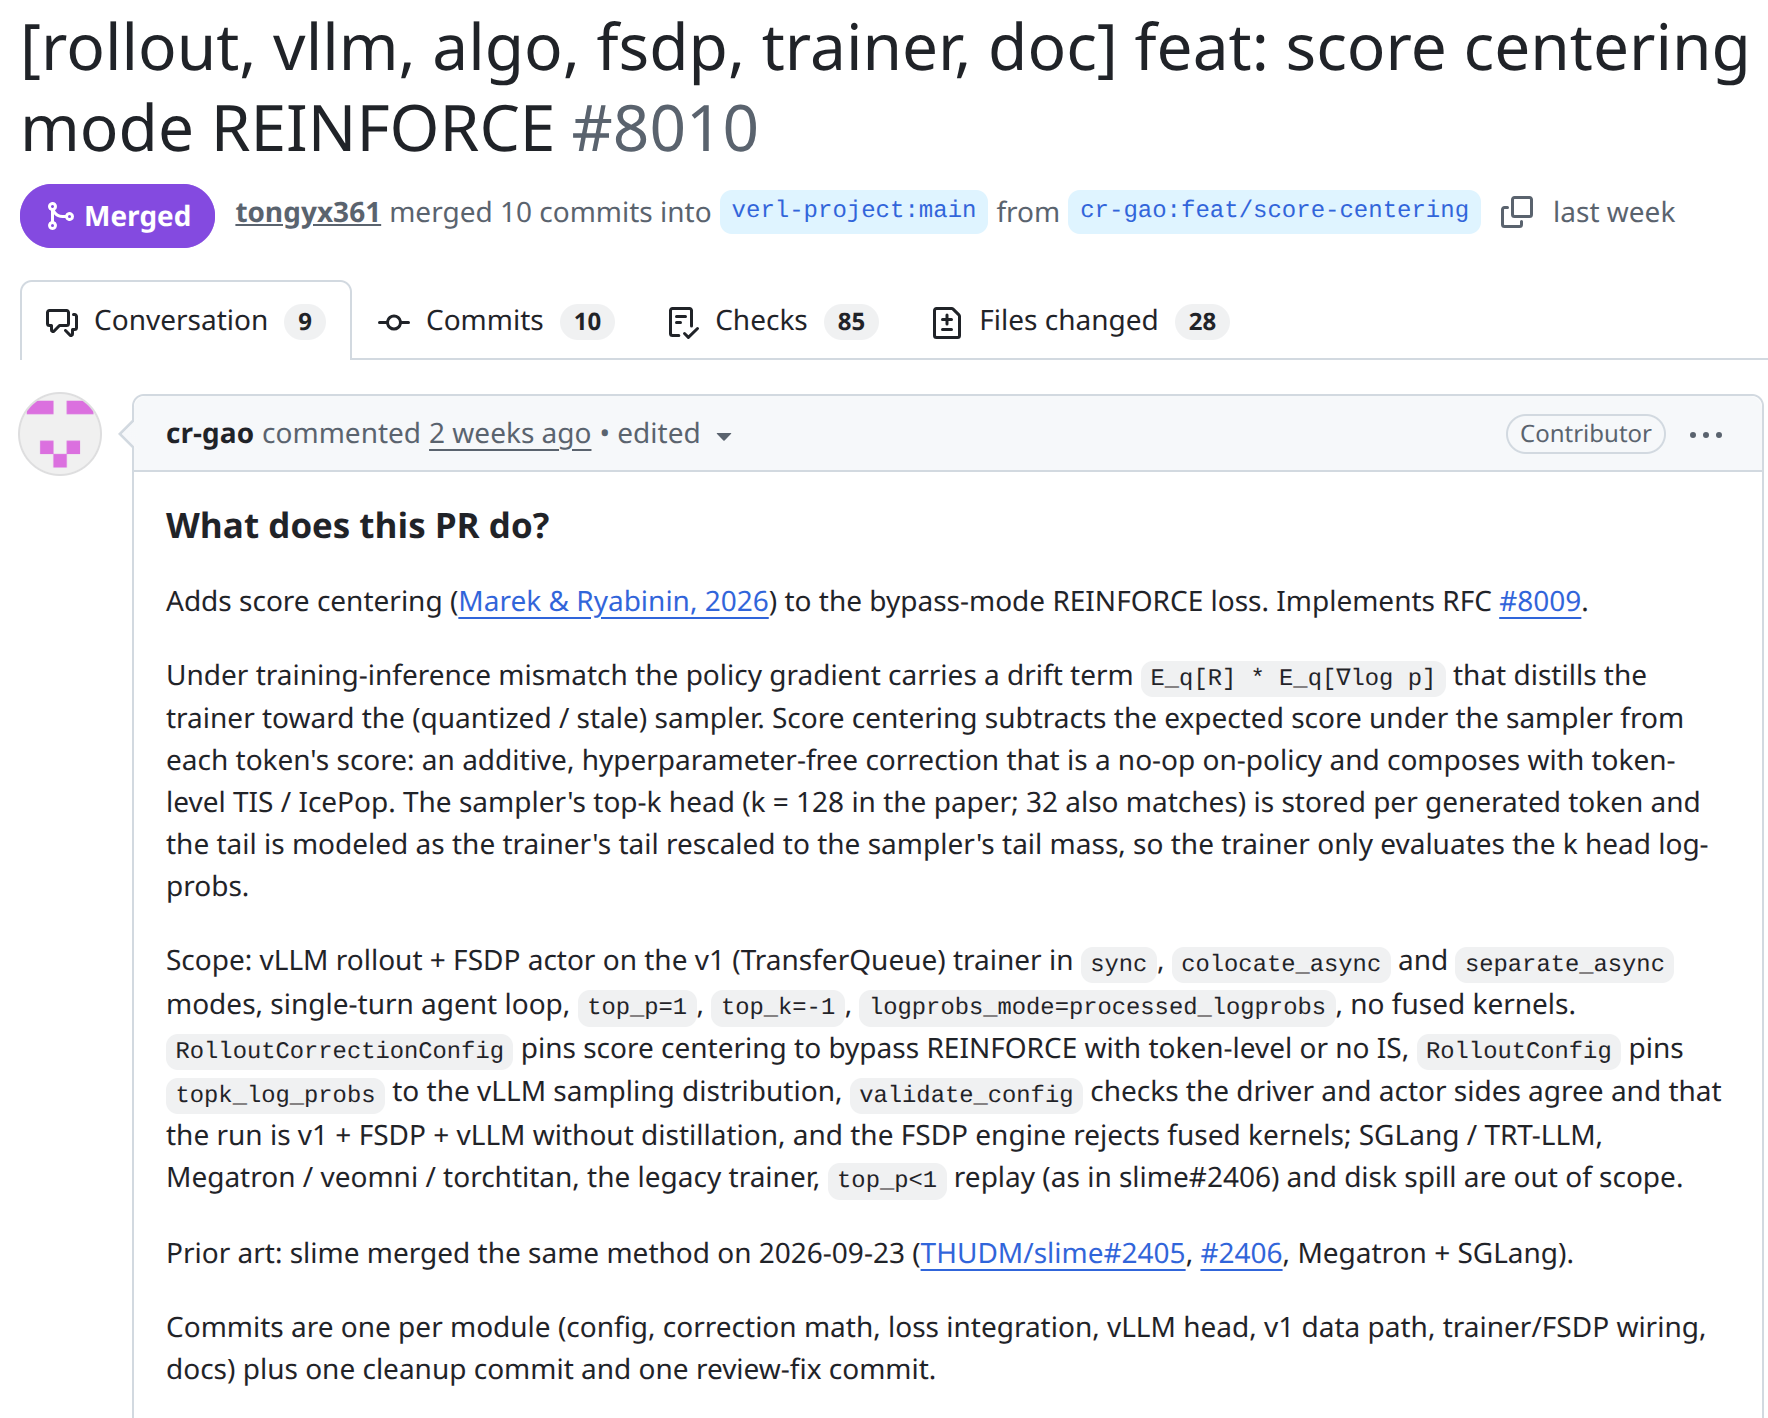
BPO 在 9 月 14 日发表。其一层梯度近似之后,与完整 SC 梯度结构相同。BPO 的作者们分别在知乎和 huggingface 上和大家分享了这一发现。
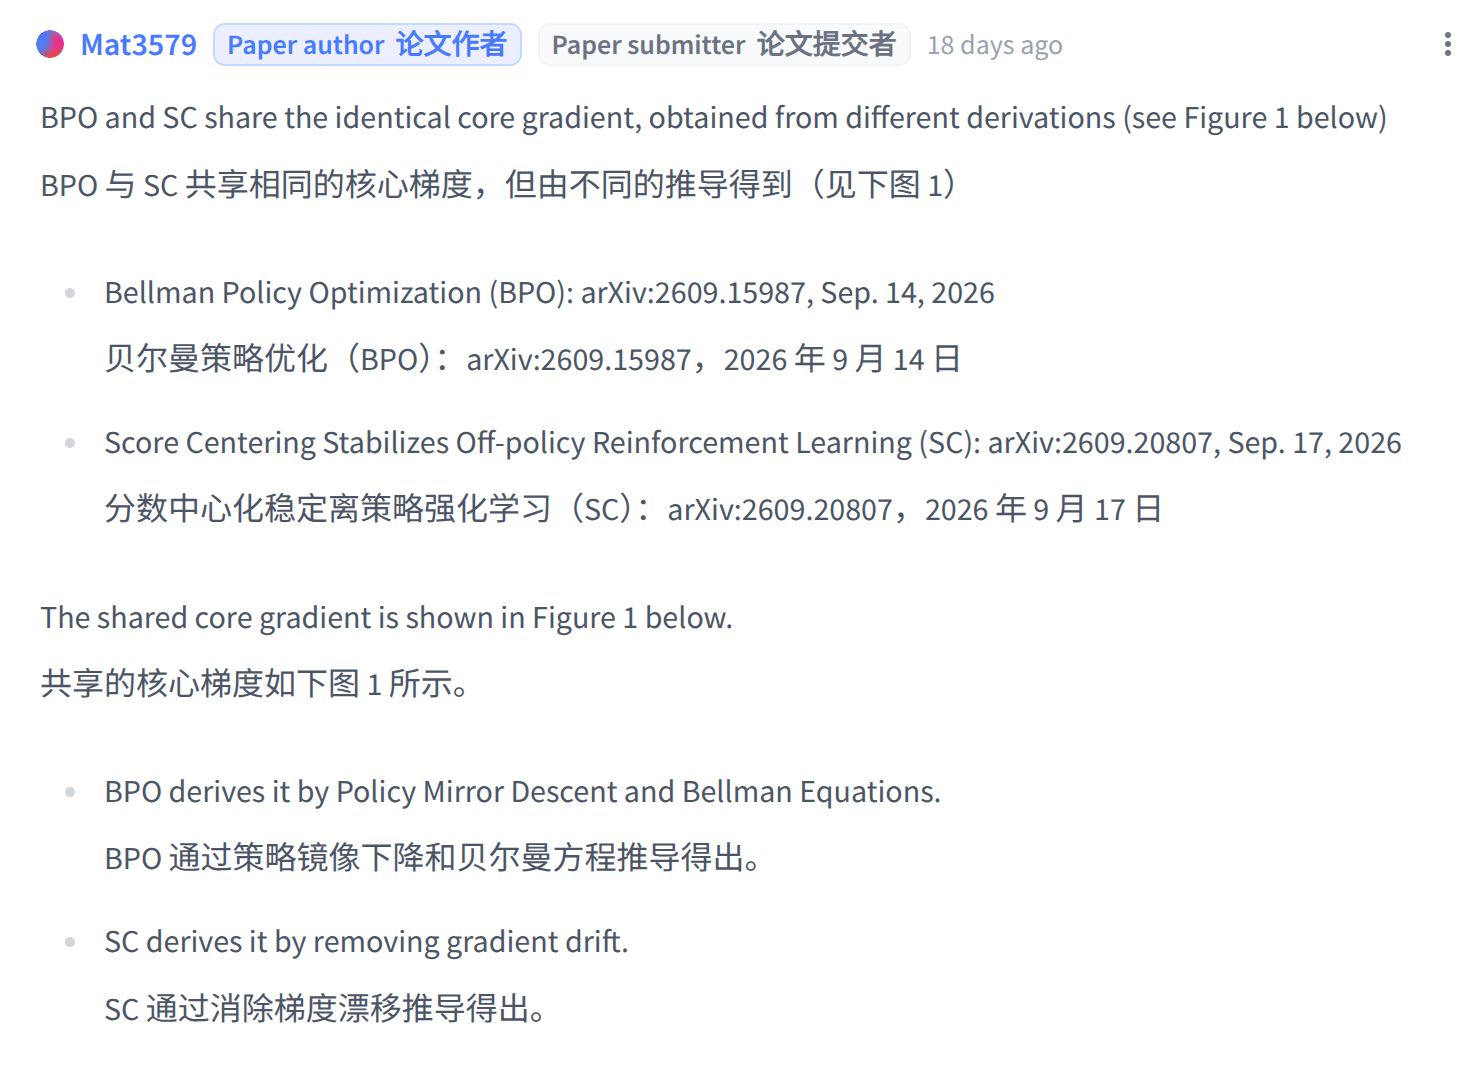
在工作被广泛关注后,人们开始从不同的问题入手重新解释 SC,揭示了其本质。具体来说:为什么训推不一致会制造额外更新??把减去的 baseline 设为理想的采样器 value,能否进一步推导??在模型更新的原点分布,能不能得到一个近似梯度??
于是科学家们提出了以下 5 种解释 🥳
0. 本文的符号约定与预备知识
0.1 概率、参数、score 函数、奖励
固定一个生成前缀,记为 $h$。其包含 prompt 和已经生成的 token。
接下来讨论单个位置时,省略条件 $h$ 不写。
- $\mathcal V$:词表。
- $\theta$:trainer 训练器参数。
- $p_\theta(a\mid h)$:trainer 训练器计算的下一 token 概率。
- $q(a\mid h)$:sampler 实际采样器的下一 token 概率。
- $s_\theta(a\mid h)$:这就是 score 函数,它是 $\nabla_\theta\log p_\theta(a\mid h)$。
- $m_q(h)$:$\mathbb E_{a\sim q}[s_\theta(a\mid h)]$,是平均 score,注意是从 $q$ 采样。
- $R$:rollout 的终局奖励。
- $B$:实际会乘在 score 上的标量权重,可以是奖励,也可以是 advantage。
- $\operatorname{sg}$:stop-gradient,也就是
detach。本文 actor 更新中,反向传播不会传到采样器 $q$、奖励等。
本文统一采用更新的上升方向 $G$,即定义 $G=-\nabla_\theta L$。
0.2 预备知识①,score 在自己的分布下均值为零,但是,训推不一致(TIM)改变了采样分布
第一步之所以成立,是因为 $\nabla\log p=(\nabla p)/p$。
不过,在真实的 RL 训练中,是 sampler 采样得到轨迹,trainer 进行训练。举个例子,verl 的训练框架默认用的是 FSDP,当然也可以用 megatron,这就是 trainer;而 verl 的采样框架可以用 vLLM,这就是 sampler。
既然 Sampler $q$ 生成 rollout,trainer $p$ 对 rollout 轨迹重算 log-prob。训推框架存在很大区别,比方说量化,比方说 kernel 的实现不一样,还比方说浮点误差。还有一点主要的:如果开启了异步训练(比如,verl 可以开启全异步),那么异步带来的 staleness 样本,也会导致 $p \neq q$。
这就是 TIM(training-inference mismatch)。
所以,对于我们恒为零的上式,把里面的分布 $p$ 换成 sampler $q$ 之后:
这通常不等于零。综上,$\mathbb E_p[s]=0$,但通常 $\mathbb E_q[s] \neq 0$。
0.3 预备知识②,回顾策略梯度(PG)
迅速回顾普通的策略梯度(Policy Gradient,PG)。考虑单步,选择动作 $a$,获得奖励 $r(a)$,$r(a)$ 与 $\theta$ 无关。
在 LLM 的 RL 中,我们的目标就是,最大化分布的平均奖励:
速推 PG,不多说。因为 $\nabla_\theta p_\theta(a)=p_\theta(a)\nabla_\theta\log p_\theta(a)$,所以
这就是 PG。注,上文的 $p$ 是泛指一个策略,并非训练器。(实际上,我们真正想优化的,肯定是在推理引擎上的效果。)
在实际训练中,动作来自 sampler 的分布 $q$。因此,直接用这些采样动作得到的奖励乘以 trainer 的 score,得到的期望更新方向是
实际更新按 $q$ 加权,但优化的却是 $p$ 的 $θ$? 如果你是 SC 的作者,你一定早已感到其中的不对劲。具体来说,你一定很想找找这个偏差破坏了哪些梯度本该持有的特性,比如减 baseline 后的期望不变。我们后面讲解。
再说一下 $Q$ 的定义。在 LLM RL 中,采样一个 token 后不会立即奖励,完整回答后才获得终局奖励 $R$。我们固定前缀 $h$、当前 token 选为 $a$、后续按策略 $q$ 生成时,平均能获得多少奖励?这个条件期望就是 $Q^q(h,a)$:
给定 $h$ 和 $a$ 后,当前 token 的 score 确定。因此,先对后续生成求平均,再对当前动作求平均,有
因此,固定前缀处分析期望更新时,可以用动作价值 $Q^q(h,a)$ 表示当前动作对应的平均终局奖励。
0.4 预备知识③,softmax 的 score
定义训练器的 logits 向量是 $z_\theta\in\mathbb R^{|\mathcal V|}$,有
定义 $e_a$ 是 token $a$ 的 one-hot 向量。
令 $J_\theta=\partial z_\theta/\partial\theta$ 为 Jacobian。
先看对数概率对第 $v$ 个 logit 求导:
其中$\mathbf1{\cdot}$ 是条件成立时为 $1$、否则为 $0$ 的指示函数。再把上式扩展到所有维度,即可得到:
这就是对 logit 求导。再进一步,即可得到对参数 $\theta$ 的求导:
对它按 $q$ 求平均,得:
1. 第一解释:原 SC 论文。消除 drift 留下 covariance
现在考虑普通 PG,也就是梯度等于奖励乘 score。
假如你是 SC 的作者,你一定常常思考:如果环境没有提供任何奖励差异(比方说,现在每个奖励恒定为 +1,那么环境就没有真的给你提供方向),观察到的更新为什么还不为零?你肯定知道是 TIM 造成的,但具体原因呢?能否精确到某一项?
1.1 环境无奖励差异时的漂移更新
令奖励恒定为常数 $c$。
对单步目标 $J_p=c$,真实梯度是应当是零。用理想情况验证一下,理想 on-policy 时,$p=q$,又根据 $E_p[s_\theta]=0$ 有:
但现实情况使用 $q$ 采样、$p$ 求 score,因此
它可能非零。尽管环境没有区分哪个动作更好,这个漂移更新仍然存在。
1.2 梯度进行协方差分解
定义标量 $B$ 为 $s$ 在梯度中乘的系数,例如刚刚的奖励恒定纯 PG 中,$B$ 就是 $c$。它与 $s$ 的协方差是
其中,等号右边的第一项就是梯度 $G_{\mathrm{plain}}$。所以把等号右边第二项移项到左边,并称之为 $\text{drift}$。
当 $B$ 为我们 1.1 中说的常数 $c$ 时,协方差项为 0。此时剩下 $\text{drift}$。既然 $p=q$ 时 $\text{drift}=0$,考虑消去 $\text{drift}=\mathbb E_q[B]m_q$。
定义 SC 操作:
因为 $m_q$ 在固定前缀处是固定向量,所以得到:
把梯度 $G$ 中的 $s$ 换为 $\widetilde s$,得:
现在,把它与理想 on policy 对比:
注意 SC 消除了 drift,与理想 on-policy 唯一的区别是,SC 的协方差仍在采样分布 $q$ 下计算。一般不等于训练器分布 $p$ 下的理想更新。
1.3 小证明,drift 是蒸馏方向
固定 $q$,那么以 sampler 为教师的交叉熵可以写为:
求导:
因此很直观,当 $\mathbb E_q[B]>0$ 时,drift 的方向与降低这个交叉熵一致;均值为负时方向反过来。训练器朝 sampler 的分布蒸馏。
当开启异步时,sampler 是随 trainer 刷新的量化或陈旧副本,这种蒸馏偏差会在更新和权重同步中反馈累积。关于异步、副本陈旧,verl 的文档里有一张便于理解的图:
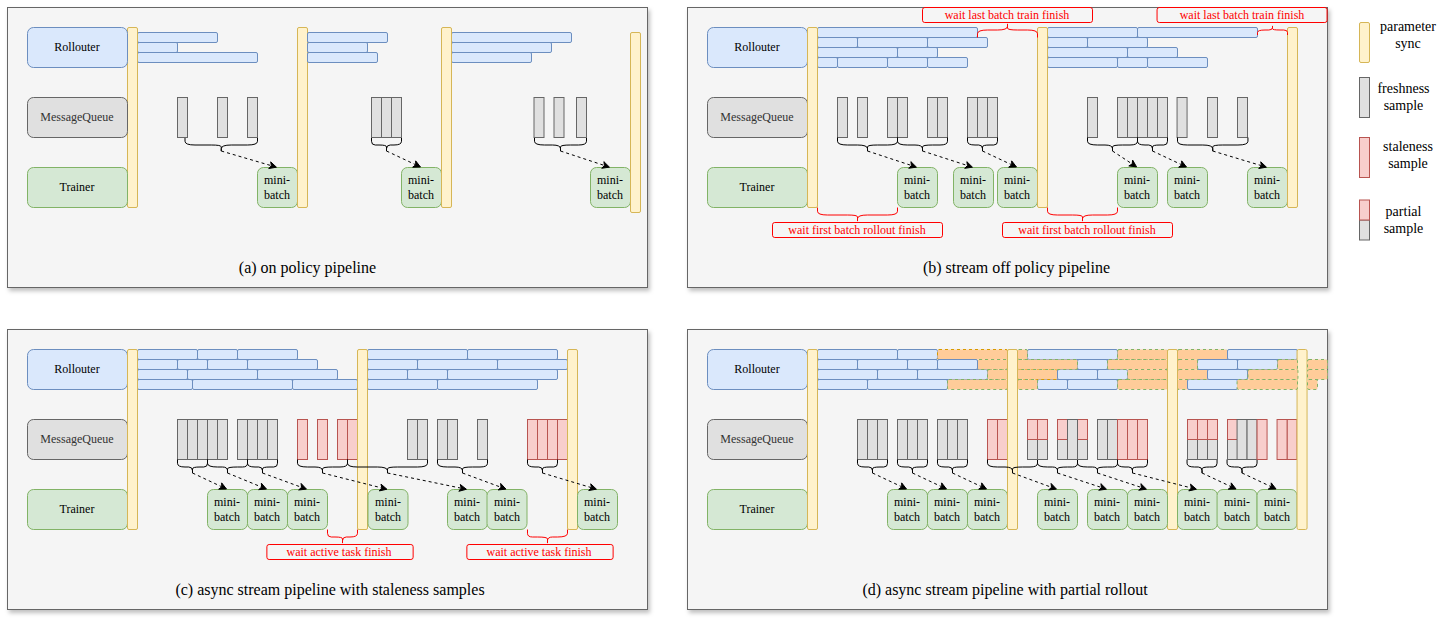
上图的右下角即为全异步引起的陈旧。
1.4 SC 恢复的理想特性:「减 baseline 后的期望不变性」
SC 恢复了理想 on-policy 情况下的一个性质:减去与当前动作无关的 baseline,期望更新不变。
我们固定前缀 $h$,令 $b(h)$ 为只依赖前缀、不依赖当前动作的任意一个标量 baseline,比方说它可以是当前前缀的 value $V^q(h)$,具体实现上可以用组内中心化来采样实现。在本次 actor 更新中,将 $b$ 视为固定量。
理想 on-policy 时,因为 $\mathbb E_p[s_\theta\mid h]=0$,所以 PG 的梯度是:
但是实际情况动作来自 $q$,PG 的 score 的均值可能非零,因此减 baseline 会改变更新的期望,也就是,
如果用 SC 将 score 中心化后,就有 $\mathbb E_q[\widetilde s_\theta\mid h]=0$,于是有
这就是 SC 恢复的 baseline invariance 特性。
实际上,你可能隐约感到了另一种解释。人们通常会很想选取 sampler 的精确 value 作为 baseline,因为减掉此 baseline,就能比较某个动作相对于当前策略的平均表现是更好还是更差。不过,人们只能通过采样来估计 value。如果在公式内进一步用精确 value 推导呢?这里就引出了后文的第三条解释 😉 它也能独立推导出 SC。我们稍后再说。
顺便,在原始 PG 上,人们常常用 group centering 来估计 value。固定同一 prompt。定义:
- $n$:同一 prompt 采样的回答条数。
- $R_i$:第 $i$ 条回答的终局奖励。
- $\overline R$:这组回答的平均奖励。
- $B_i$:第 $i$ 条回答的 advantage,乘在 score 上。
因此
如果再除以组内奖励标准差,就得到常见的组内标准化 advantage。
1.5 社区实现简述
我这里是顺手记一下 ☺️ 如果你想速览其他解释 SC 的角度,可以跳过这一节。
下文以 verl 为例。PR #8010 于 2026 年 10 月 1 日合并,把 SC 加入 bypass-mode REINFORCE,使用 sampler top-k 概率重建平均 score。文档在:rollout correction 文档 。
1.5.1 不要全词表
对于完整词表,SC 的 per-token loss 是
之所以说是「完整词表」,就是因为上式中的 $\sum_v$ 会遍历整个 vocab。
对此 surrogate 自动微分就得到我们需要的 $-\nabla L=B(s_a-m_q)$。
但是,保存和传输 sampler 完整概率分布太贵。
每个生成位置都要保存 $|\mathcal V|$ 个概率,若词表约 15 万,使用 fp32,每个位置就需要约 600 KB。
因此 verl 和官方 SC 实现保存 top-$k$ 概率,并用 trainer 的分布去近似尾部。
1.5.2 top-k
令 $H$ 是 sampler 概率最大的 $k$ 个 token 的集合,$T=\mathcal V\setminus H$ 是尾部。记
重建 sampler 分布为
注意其保留 sampler 的真实 k 个头部 token 概率,并按 trainer 的尾部分布形状填入 sampler 的尾部总质量。这样构造后,可以有 $\sum_v\widehat q_v=1$。
下式第一步,利用 $\sum_vp_vs_v=0$:
因此,loss 只需要 head 的 trainer log-probs:
这样,top-$k$ 节约了传输和存储成本。
1.5.3 SC + TIS/MIS
其实,重要性采样(Importance Sampling,IS)本来就可以精确校正采样分布与目标分布的不一致。人们为什么不用精确 IS 呢?为什么要用 TIS/MIS 等方式截断呢?
固定一个前缀,定义概率比值
假设 $p_a>0$ 的动作都有 $q_a>0$,对于同一个固定动作权重函数 $B(a)$,有
它将 $q$ 下的加权期望精确变回了 $p$ 下的期望。同样,精确 IS 加权后的 score 均值是
因此,精确 IS 已经消除了这里的 mean-score drift,不需要再用 SC 扣除一个非零均值。
那为什么还需要 SC?精确 IS 的权重可能很大,导致梯度估计的方差很高。
注意,这里是 token ratio,修正的是固定前缀下的动作分布。若要精确恢复完整序列目标,还需要完整轨迹的概率比值,在 verl 里就是开启 rollout_is: sequence,那么方差就可能更大了。
因此,人们用 TIS 或 MIS 来限制极端权重。令 $c>0$ 为上截断阈值,$0<\ell\le u$ 为保留区间:
- TIS:$w_a=\min(r_a,c)$,将过大的 ratio 截断。
- MIS/IcePop 区间权重:$w_a=r_a\mathbf1{\ell\le r_a\le u}$,区间外的权重置零。
现在的 IS 方差被控制住了,但是有偏了。这时 $q_aw_a$ 一般不再等于 $p_a$,所以加权 score 的均值可能重新变成非零:
上式中,下标 $f$ 表示所采用的权重规则,即 $w_a=f(r_a)$。原更新分解成:
这就是为什么 SC 可以与 TIS/MIS 结合:先用 TIS/MIS 给 score 加权,再用 SC 减掉加权 score 的均值。 SC + TIS/MIS 后,单样本更新梯度为
期望为
注意其中减去的是 $m_f=\mathbb E_q[ws]$。
精确 IS 时,$w=r$,$m_f=0$,SC 的附加修正自然是消失的;TIS/MIS 留下非零均值时,SC 才继续消除这一项。
最后,SC + TIS/MIS 也需要 top-$k$。在重建尾部上,$\widehat q_v=\rho p_v$,所以 $p_v/\widehat q_v=1/\rho$。令
则 expected weighted score 的 head-only 形式为
各规则对应如下 $\alpha$:
最后 loss 是
(采样 token 如果落在尾部、不在 head 中呢?那仍要保存其 sampler log-prob,以计算 IS 权重。你可能想说,我采样如果不是整个词表呢?这样就不用考虑落到尾部的情况了,比如我开启 top-k 或 top-p 采样再 SC,verl 社区目前也在完善这样的支持:PR #8196)
1.5.4 verl 实现简述
核心文件为 score_centering.py。
其中,实现了 score_centering_correction() 返回标量 surrogate correction $\sum_{v\in H}\operatorname{sg}(q_vw_v-\alpha p_v)\log p_v$。它的梯度就是 $\widehat m_f$。大意是:
1 | with torch.no_grad(): |
在 core_algos.py 的 REINFORCE loss compute_policy_loss_reinforce() 中,如果开启了 SC,有
1 | pg_losses = -advantages * log_prob * rollout_is_weights |
上述代码,第一行就是
第二行就是
因为 $B$、$w_a$ 是 detach 了,求导得到
因此
2. 第二解释:BPO 从 PMD 与 Bellman 方程得到 SC 梯度
BPO 的一层梯度近似之后,与完整 SC 梯度结构相同。BPO 的作者们分别在知乎和 huggingface 上和大家分享了这一发现。
2.1 本节的符号约定
本节恢复前缀条件。定义:
- $x$:prompt,来自分布 $\mathcal D$。
- $y=(y_1,\ldots,y_T)$:回答,长度至多 $T_{\max}$。
- $h_t=(x,y_{<t})$:生成第 $t$ 个 token 前的状态。
- $\mu$:固定的 rollout policy,对应前文的 $q$。
- $\pi_\theta$:待优化策略,对应前文的 $p_\theta$。
- $\mathbb P_\mu(y\mid x)=\prod_t\mu(y_t\mid h_t)$:完整回答分布。
- $V^\mu(h)$:从状态 $h$ 开始、继续按 $\mu$ 生成时的期望终局奖励。
- $Q^\mu(h,a)$:先选动作 $a$、随后按 $\mu$ 生成时的期望终局奖励。
- $A^\mu(h,a)=Q^\mu(h,a)-V^\mu(h)$:rollout policy 的真实 advantage。
只给终局奖励、追加 token 的状态转移确定、无折扣的情况下,Bellman 方程给出:
代入 advantage 定义,它在自身策略 $\mu$ 下的均值为零:
又
得逐轨迹的望远镜恒等式:
注意终点状态的 value 就是终局奖励。
2.2 PMD 的目标与闭式解
定义 $\eta>0$ 为更新强度。PMD 是什么?就是要求解:
其中
约束是
由拉格朗日乘子法求解上述约束优化问题,得闭式解:
其中
直接应用闭式解?注意这需要每个前缀、每个动作的 advantage,大量的 rollout 才能采样估计出来;或者需要额外的 critic 成本。
2.3 消去配分函数 Z,再消去中间 value
对上述闭式解取对数:
按 $\mu$ 求平均,利用 $\mathbb E_\mu[A^\mu]=0$,根据 KL 的定义,等式两边变为:
对于本小节的第一个式子,把 $-\log Z_\mu(h)$ 替换为 $-D_{\mathrm{KL}}(\mu\Vert\pi^+)$,得
沿着回答求和,
注意已经不再需要中间状态的 value。
2.4 平方残差目标
把上式等号左右两边的闭式解结果 $\pi^+$ 换为 $\pi$,然后让它们相减,定义为轨迹残差。本小节用 $d(x,y;\pi,\mu)$ 表示轨迹残差:
为每个 prompt $x$ 指定正的 loss 权重常数 $c(x)$。定义
PMD 的解会使残差逐轨迹为零,因此我们希望让上式最小。
最小化 $L_{\mathrm{exact}}$,为什么不会出现「不同 token 残差互相抵消」的另一个解?为什么一定是 PMD 解?BPO 原论文 证明了 PMD 解与 $L_{\mathrm{exact}}$ 解的充要性。这里我就不展开了。
2.5 与 SC 梯度相同
对于单条回答,固定 $\mu$、reward、value 和 $c(x)$,对 $\pi=\pi_\theta$ 的平方残差:
求导:
又因为
所以上式的中括号内:
这里就是 SC 的中心化 score:
BPO 接着在残差变量 $d_i$ 上对平方目标做线性化,围绕 $\pi=\mu$ 时的残差,将梯度中的 $d_i/\eta$ 换成 $R_i-V^\mu(x)$。
具体来说,把平方 loss 当作残差 $d_i$ 的函数,在一个固定参考残差处做一阶泰勒展开。当 $\pi=\mu$ 时,每个 token:
所以残差中只剩奖励差:
对平方函数做一阶展开,原 loss 是
利用
舍去最后的二次项,就得到线性化 loss:
参考残差 $d_i^{(0)}$ 固定,因此求导:
代入 $d_i^{(0)}/\eta=R_i-V^\mu(x)$,再代入我们刚推导的残差梯度:
定义:
BPO 选择 $c(x)=1/\sigma_\mu(x)$,其中 $\sigma_\mu(x)$ 是该 prompt 下 rollout 奖励的标准差。再用 grouped rollouts 估计 prompt value 和奖励标准差,得到响应级权重:
(注意零标准差需工程处理)
到这个阶段,近似 token loss 梯度为
因此,使用同一个 $\mu$、同一个固定 $\widehat A_i$,并精确计算完整词表 KL 时,它与完整 SC 的 token 梯度相同。
2.6 BPO 实际使用的 loss
BPO 也不用全词表。BPO 使用二元 KL。对已采样 token $a$,记 $p_a=\pi_\theta(a\mid h)$、$q_a=\mu(a\mid h)$。把词表分成「$a$」和「非 $a$」,定义二元 KL:
用它替换梯度中的 KL:
关注中括号内,固定 $q_a$,先对标量 $p_a$ 求导:
再用链式法则:
令 $\epsilon>0$ 为加性平滑量、$C>0$ 为权重上限,定义
再令 $\epsilon_{\mathrm{low}},\epsilon_{\mathrm{high}}$ 为 clipping 边界,mask 为
BPO 实用 loss 是
3. 第三解释:从理想 baseline 得到 SC
我们还可以从 sampler 的精确 value $V^q(h)$ 得到 SC。在 SC 原论文的第四节就提出了这种解释。这也是一个非常直观的入手点。
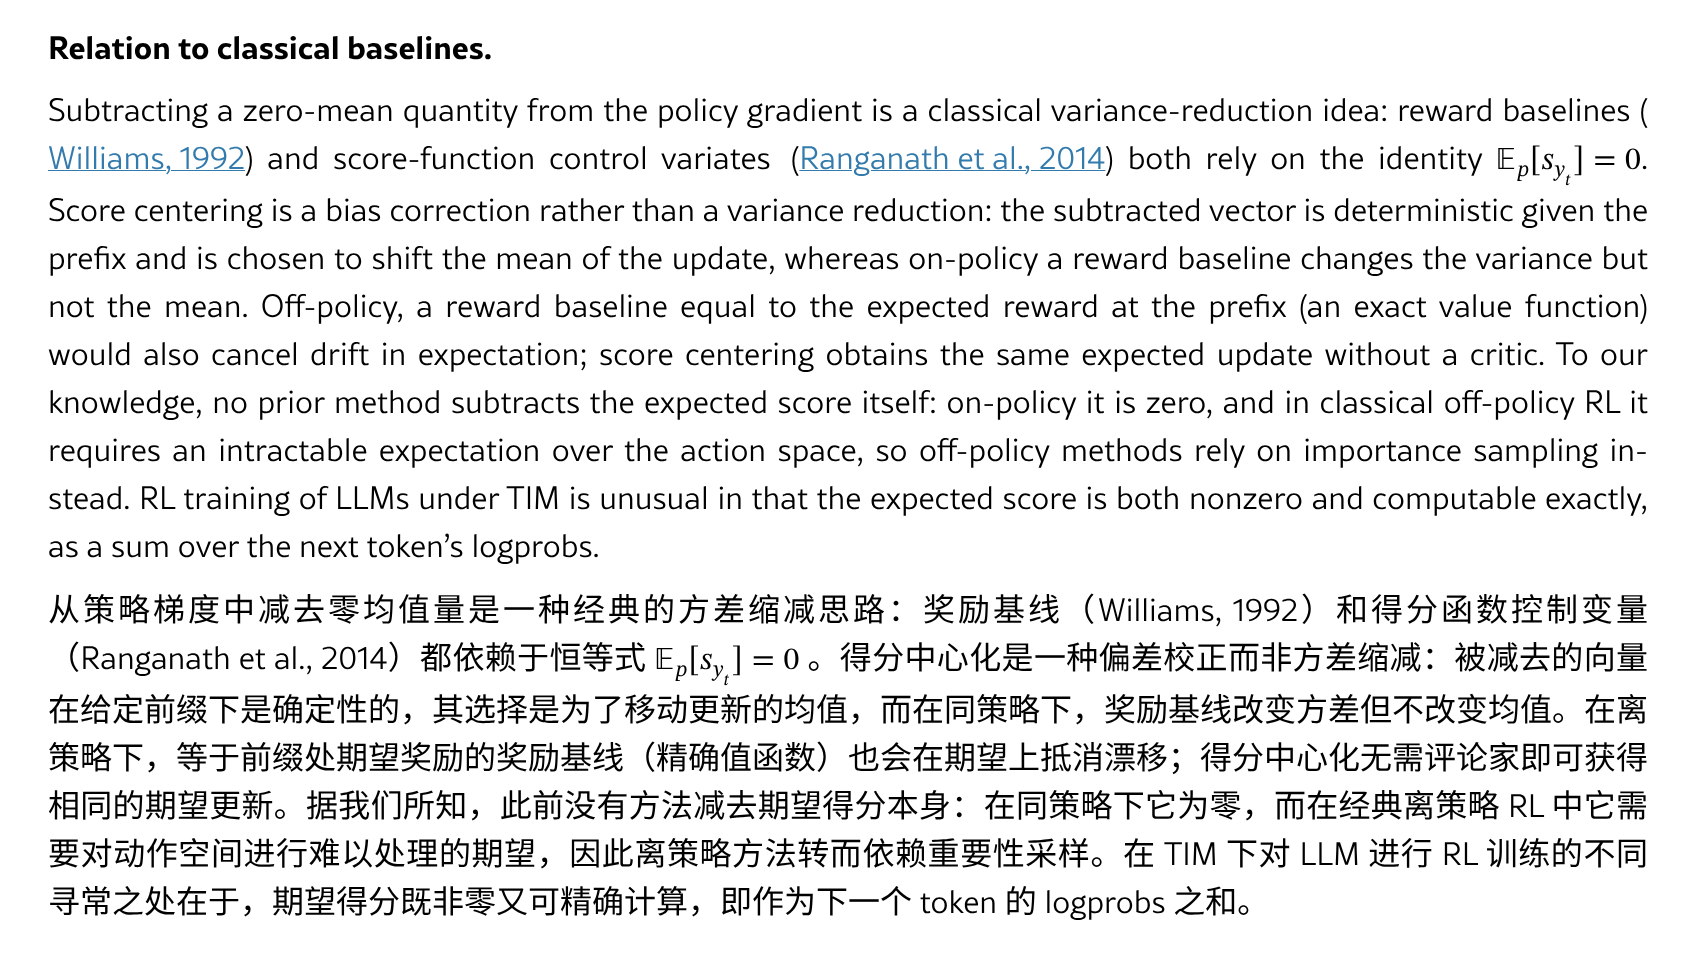
3.1 从精确 sampler value 出发
固定前缀 $h$,定义:
注意上标是 $q$ 是 sampler。在 actor 求导中 $Q^q,V^q$ 固定。
从使用 advantage 的更新开始,省略 $h$:
其中 $m_q=\mathbb E_q[s]$。因此:
由此可见,对价值减掉精确 sampler baseline 在期望更新上等价对 score 减掉 sampler 均值。
前者需要一个精确的 value $V^q(h)$,要想估计,或者需要大量采样,或者需要 critic。后者直接求词表期望。
4. 第四解释:SC 是 STE
dung defender 的知乎文章 最早提出了 score centering 的 STE 解释,原文非常精彩!推荐你去阅读一下 😄
4.1 STE 用 $q$ 前向
构造
固定 $q$ 时,前向永远得到 $z_q$,所以 $\operatorname{softmax}(\widetilde z_\theta)=q$。
但是,
其中 $J_\theta=\partial z_\theta/\partial\theta$ 是训练器 logits 对参数的 Jacobian。
因为
所以
而
所以,这个 STE 构造按自动微分规则得到的梯度,恰好等于 SC 的中心化 score:
4.2 不过这两个梯度相同的 surrogate 数值不同
固定权重 $B$,定义
前者普通求导、后者按 STE 自动微分,梯度更新都为
但前者 loss 数值不等于 $-B\log q(a)$,后者前向值就是它。
4.3 知乎原文:固定旧差值的 surrogate
前面用的是当前差值构造。知乎原文用的是固定旧差值,令 $\theta_0$ 为固定旧参数,定义
这里 $\Delta z$ 固定。
因此
起点处 $\widehat p_{\theta_0}=q$;离开起点后,$\widehat p_\theta$ 变化。
固定偏移以后,普通求导即可得到
在起点处,它是 $J_{\theta_0}^\top(e_a-q)$,也就是 SC。
(这里取更新起点处的局部进行观察,实际上与下面第五种解释完全一样!因为固定了局部,差值为常数,所以上面本来就不用显式地写 $\text{sg}$。)
4.4 固定偏移目标离开起点后不同于 SC
在单步固定奖励 $r(a)$ 下,代理期望奖励可以写成
因此
在起点,ratio 为 $1$,$\widehat p=q$,得到 SC;离开起点,ratio 和 score 中的分布都改变。而纯 SC 用固定 $q$ 时是:
所以,上文所说相同,范围是离更新起点相近的局部。
5. 第五解释:局部分布族
局部分布族解释源于 𝕏 上几位科学家的交流讨论:
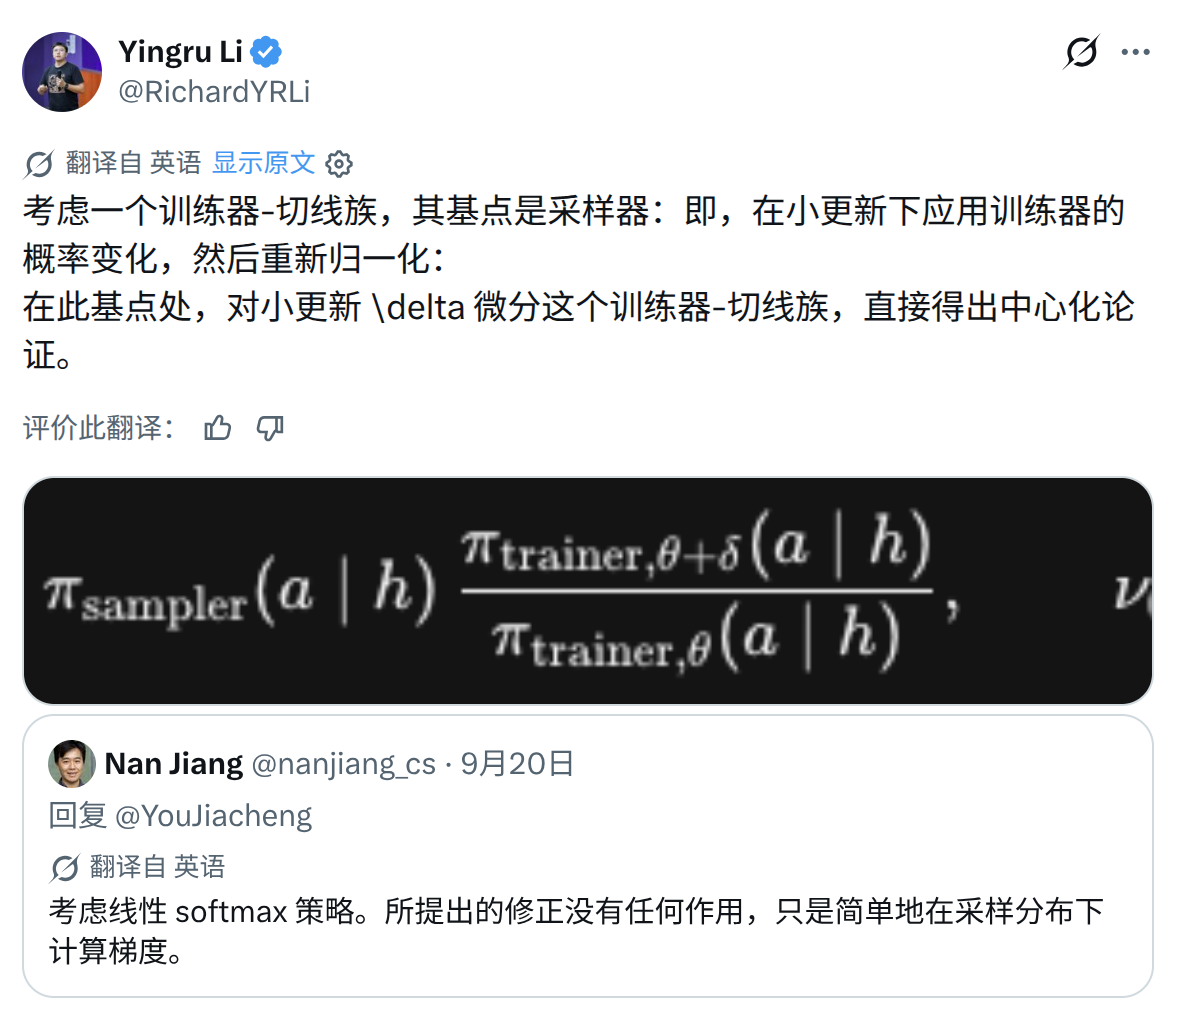
5.1 先看线性 softmax
令 $\phi(a)$ 是与参数 $\theta$ 同维度、不随 $\theta$ 变化的动作特征向量。定义
这就是线性的 softmax。
对它求对数概率梯度,得到普通的 score 是:
如果把 score 再按 $q$ 求平均:
因此,SC:
这说明:SC 将 softmax 梯度中的平均特征权重从 $p$ 换成了 $q$。
对于一个线性 softmax,进行 SC 的变化后,所选动作的特征 $\phi(a)$ 保留,被减去的平均特征从 $p$ 下的平均值换成 $q$ 下的平均值。那么,能不能构造一个从 $q$ 出发的分布族,使它的真实 score 就是这个中心化结果?
5.2 定义:分布族、基点、trainer-tangent
令 $\theta_0$ 为当前固定参数、$\delta$ 为参数增量,也就是说新参数是 $θ = \theta_0 + \delta$。每个 $\delta$ 对应一个概率分布,整组分布记作 ${\nu_\delta}$,这就是分布族。「基点」是 $\delta=0$ 对应的起始分布。
先定义:未归一化权重是「把训练器的相对概率变化施加到 $q(a)$ 后得到的数值」:
再定义归一化后是 $\nu$:
既然归一化了,那么就可以说,$\nu$ 是我们新构造的一个概率分布。具体来说,$\nu_\delta(a)$ 表示:参数改变量为 $\delta$ 时,新分布赋给动作 $a$ 的概率。
$\nu$ 从 sampler 分布出发,施加 trainer 的相对概率变化。$\delta=0$ 时,$w_0=q$、$Z(0)=1$、$\nu_0=q$。
你可能疑惑 $\nu$ 是什么,目前来看,是在人为定义一个分布。但构造有明确目的的,我们求导看看。
5.3 求导时注意
在刚刚这个构造中,起点参数 $\theta_0$ 和采样分布 $q$ 固定,
参数增量 $\delta$ 是变量,更新后的参数为 $\theta_0+\delta$。
因此,在对 $\delta$ 求导时:
- 旧概率 $p_{\theta_0}(a)$ 固定。
- 更新后的概率 $p_{\theta_0+\delta}(a)$ 随 $\delta$ 变化。
- 归一化因子 $Z(\delta)$ 也随 $\delta$ 变化,需要求导。
这里对 $\delta$ 求导,本质上就是对更新后的参数求导:
令 $\theta=\theta_0+\delta$,即
接下来,对整个 $\log\nu_\delta(a)$ 求导时,注意以上。
5.4 求导,然后发现平均 score 来自于归一化
对 $\nu$ 取对数:
前三项,仅中间的更新后概率依赖 $\delta$。因此
展开最后那个归一化项:
因此
归一化的普通导数自然产生了 SC。
5.5 分布族的局部奖励目标
在单步固定动作奖励 $r(a)$ 下,定义
对它求导,并使用 $\nabla\nu=\nu\nabla\log\nu$:
可见:SC 的期望更新,恰好是这个分布族的期望奖励目标在起点 $\delta=0$ 处的梯度。
因此,SC 可以理解为:以采样分布 $q$ 为起点,沿着训练器提供的概率变化路径,局部提高期望奖励,优化采样器策略。
5.6 分布族改写成 logits 形式后,与 STE 一致
定义三个 softmax 分母:
把它们代入我们刚刚构造分布时未归一化的分子:
由于公共因子 $C_0/(C_qC_\delta)$ 可以随 $\delta$ 变化,但不随 token $a$ 变化,所以除以 $\sum_b w_\delta(b)$ 时会消掉。我这句话具体是说,如果把这个公共因子记为
再记
于是前面得到的未归一化权重是
对所有 token 求和时,$K(\delta)$ 都相同,所以
因此
即
也就是
令 $\theta=\theta_0+\delta$,它与知乎 STE 文章的固定旧 logits 差值构造是同一个函数!
因此,第四种解释和第五种解释,本质是同一个,不过「STE」与「构造分布」的思考出发点不同(比如分布族更关注对应什么局部优化目标),而且都特别精彩,因此我分开记录了。
两个构造本身就是同一个分布族的两种写法。
(这里也有个有趣的点,更一般地,可以将基点换为合适的固定分布 $\mu$,定义 $\nu_\delta\propto\mu p_{\theta_0+\delta}/p_{\theta_0}$,起点 score 就是 $s-\mathbb E_\mu[s]$。)
5.7 对比:假设 sampler 可微
我们直接假设 sampler 对参数可微。工程上肯定不能在 sampler 里反向传播,只是假设。
若实际 sampler 的 logits 为 $z^{\mathrm{samp}}_\theta$,真实参数 Jacobian 应为 $J^{\mathrm{samp}}_\theta=\partial z^{\mathrm{samp}}_\theta/\partial\theta$。在可微条件下,它的 score 是
SC 则使用训练器的 $J_\theta^\top(e_a-q)$。
因此真实导数属于构造出的分布族。
5.8 上文是单 token 级。简单推一下整条序列级
对每个可能前缀 $h$ 都构造同一个参数增量下的条件分布 $\nu_\delta(a\mid h)$。定义其完整回答分布
在有界长度、可微和共同支持集条件下,起点处完整分布等于 $\mathbb P_q$,并且
因此对于固定终局奖励函数 $R(x,y)$,
综上所述
以上就是「五等分的 Score Centering」,汇总了目前五种解释 SC 的视角 😉
Reference
论文与实现
- Martin Marek、Max Ryabinin:Score Centering Stabilizes Off-policy Reinforcement Learning。
- Zhuoqing Song、Haotian Xu、Xikun Zhang、Lidong Bing:Bellman Policy Optimization。
- SC 官方仓库。
- verl 实现。
各解释出处
- haotian:贝尔曼策略优化以及 score-centering,score-centering 的前世今生。
- dung defender:OPENAI 的神秘 RL 算法只是个 STE 的近似吗?解密 OAI 的 RL 后训练算法。
- Yingru Li:trainer-tangent family 原帖。