同策略的 RLVR,例如 GRPO 等,对 inference compute 有很高的要求。
这是阅读的出发点,但是也记录了别的工作。有点杂,仅方便我个人回顾。
长程 agent 任务异步 RL,每个 prompt 只采一条 rollout。价值模型估计学习信号。双侧 token clipping 稳定离策略更新。
分析了同策略时的策略熵崩溃。提出 Clip-Cov 和 KL-Cov,限制高协方差 token 的更新,以延缓熵崩溃并维持探索。
发现高熵区域常对应逻辑转折、自我检查和少见的推理行为,因此直接在优势函数中加入熵相关项。促进更长、更深入的探索式推理。
解耦裁剪和动态采样的策略优化方法。公开的训练系统与数据。改进 GRPO 的细节。
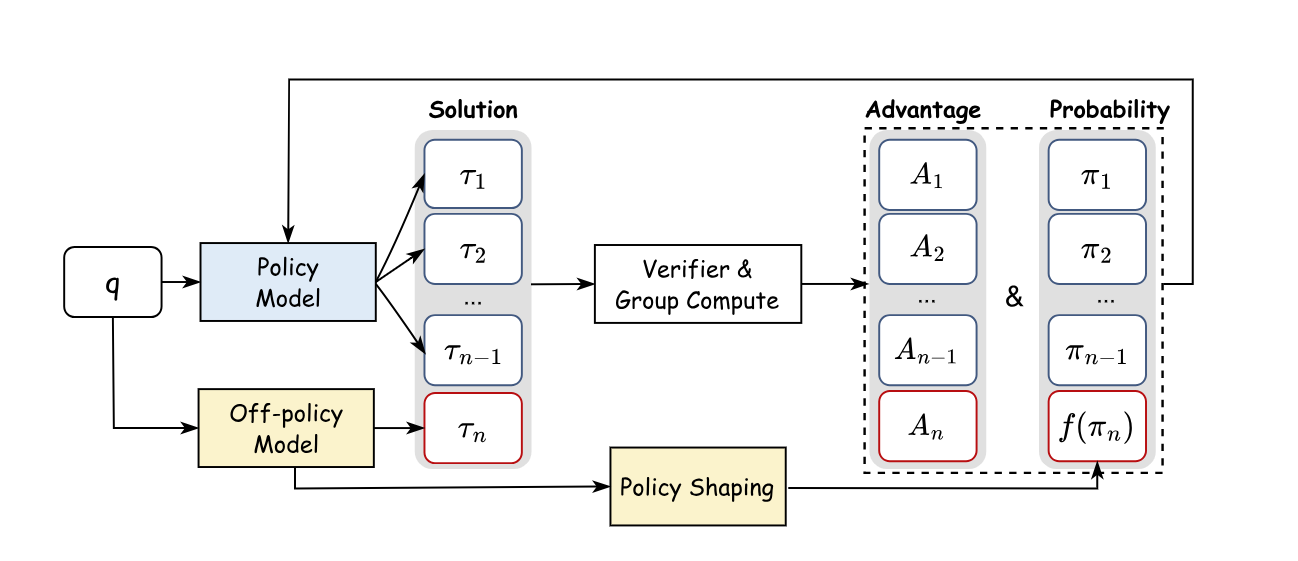
把外部专家的离策略推理轨迹与模型自身 rollout 混合进 GRPO,使模型能从当前能力范围之外的示范中学习。通过正则化重要性采样进行 policy shaping,在模仿与自主探索之间取得平衡。
提出 GRPO。
推理链中只有少量 token 具有高熵,却往往决定后续推理走向,论文将它们称为 forking tokens。仅对熵最高的约 20% token 做策略梯度更新,就能在其设置下持平甚至超过全 token 更新,说明学习信号高度集中。
同样发现 RLVR 的有效改变集中在少数关键 token 决策上。只替换少量 token 就能恢复或破坏大部分性能增益。
异步 RL,重要性 ratio 的自然波动尺度与 token 熵有关。ESTR 用局部熵缩放离策略偏离。提高异步 RL 的稳定性和训练效率。
研究旧 rollout 在高度滞后的情况下还能利用多久,发现崩溃前的 stale data 仍包含有效学习信号。M2PO 约束重要性权重的二阶矩,重点抑制极端高方差 token,在实验中能够稳定利用落后至少 256 次更新的数据。
把历史策略生成的离策略数据与当前策略的新数据混合。用更高的 Update-To-Data ratio 比率反复训练。让 PPO、GRPO 重复利用历史 rollout,减少重新生成数据的成本。KL-Convex 约束和 policy reincarnation 用于协调早期数据复用与后期稳定提升。
针对 GRPO 将整条轨迹的优势均匀分给所有 token 的粗粒度信用分配,引入折扣后的 future-KL 构造更密集的优势。根据 token 对后续轨迹行为的影响调整更新权重。
从 KL 正则化 RL 的最优性条件推导策略隐含的价值函数,用 policy/reference 的 log-ratio 建立价值递推,无需额外训练 critic。将结果奖励通过 value loss 纳入训练,再用独立的 actor 更新改进策略,以获得比整条轨迹共享优势更细的信用分配。
haotian 发表的文章。
研究训练与推理引擎在相同权重、相同序列上给出不同 token 概率的 Training-Inference Mismatch。通过 VeXact 零失配诊断设置隔离这一因素,表明微小数值差异也能独立导致训练崩溃,并改变实际优化目标。
利用专家轨迹引导可控探索,缓解熵崩溃与分布失配。结合基于组内稀有度的优势加权与非对称激活,抑制过度自信的更新,同时保留纠错方向。
CalibRL:同一个 policy 下,两条不同 trajectory(自己和专家的);VeXact/TIM:同一条 trajectory,在两个 distribution/engine 下。
这里需要注意一下,专家轨迹的分数虽然也是用当前 $\pi_\theta$ 累乘算的,但算完便 detach,只充当动态阈值。
提出了离策略值函数。
DPO 中,KL-regularized reward maximization:
它的最优策略具有闭式解:
其中归一化常数:
反解 reward:
DPO 称之为 the optimal solution to the KL-constrained reward maximization objective。中文名:指数倾斜分布。
利用它,消去了显式 reward model。
利用 KL 正则化奖励最大化的闭式最优策略,将奖励重参数化为策略相对参考模型的 log-ratio。代入成对偏好模型后,归一化项相消,得到直接训练策略的分类损失,省去单独的奖励模型和在线 RL 采样。
通过偏向高值的 expectile 回归隐式估计数据内较优动作的价值,避免在离线训练中查询数据分布外动作的 Q 值。随后用优势加权的行为克隆提取策略,是理解离线数据复用与分布外价值高估问题的经典方法。
将 OPSD 教师看到的当前题参考解替换成另一道题及其解答,在保留学生 rollout 和蒸馏目标的情况下仍获得接近 OPSD 的收益。结果说明收益未必完全来自当前题的特权答案,参考上下文对教师行为的改变本身也是重要因素。
直觉:语言模型是分布。优化分布的方法不一定会符合常理。
解决自信冲突(模型预测熵很低,却被要求学习自身赋予低概率的目标 token)以缓解遗忘。
RFT 更能保留旧任务和通用能力。RIF-RFT 用 rollout 筛选仍有学习空间的样本,提高训练效率。
发现 RL 微调的有效参数变化自然集中在一个小子网络中,仅训练这些参数就能恢复接近完整微调的效果。这里的稀疏性分布在各层参数矩阵中,且更新仍接近满秩。彩票假说。
动态挑选困难样本插入 SFT,为 RL 补充仅靠自身轨迹难以获得的外部知识。
为减少 SFT 对已有 RL 能力的破坏,只在高熵 token 上计算损失,冻结对 RL 重要的参数。
SSD / Simple Self-Distillation
违反直觉。要注意语言模型是一种分布,哪怕训练数据是乱码,只要优化了分布,也能提升性能。
用模型自身在特定温度与截断配置下采样的原始代码回答做 SFT,无需正确性筛选、外部教师或 RL,也能提升代码生成表现。
自蒸馏会按上下文重塑分布,在需要精确的位置压低干扰尾部,同时保留有用的多样性。
研究 OPD 的成功条件:师生需要兼容的思考模式,教师还必须提供学生尚未掌握的新能力,仅有更高的教师分数并不充分。其 token 分析强调学生访问状态上的高概率区域对齐,并提出离策略冷启动与教师对齐的 prompt 选择来挽救失败的蒸馏。
把 OPD 的数据量压到单个 query,发现持续训练仍可恢复完整数据训练的大部分收益。论文用 rollout 的状态覆盖解释这一现象,并指出瓶颈可能更多在于学生吸收教师信号的更新效率,而非 prompt 数量。
Xiaomi 先分别训练多个领域 RL 教师,再让它们在学生自身 rollout 上提供密集监督,将各领域能力整合进同一学生。
OPD Failure Modes / Top-K Matching
分析 sampled-token OPD 的三类失效:token 监督失衡、教师在学生偏离的前缀上指导不可靠,以及 tokenizer 或特殊 token 不匹配。提出在教师 top-K 支持集上做局部分布匹配,并结合 top-p rollout 与特殊 token masking,以改善长轨迹蒸馏的稳定性。
从 RL 的变分推断视角出发,说明参考答案、成功轨迹或反思等特权信息如何帮助构造更有用的教师分布。重点是理解自蒸馏与特权信息蒸馏的目标、假设和失效条件,适合与 DPO 的指数倾斜分布推导对照阅读。
https://arxiv.org/html/2608.06296
减少训练—推理分布
https://arxiv.org/html/2306.08543
https://arxiv.org/html/2306.13649
减少灾难性遗忘
https://arxiv.org/html/2509.04259
https://arxiv.org/html/2402.03898
https://arxiv.org/html/2503.07067
https://arxiv.org/html/2604.13010
https://arxiv.org/html/2601.18734
https://arxiv.org/html/2305.11206 ➡️ https://arxiv.org/html/2502.03387
https://arxiv.org/html/2505.24298
https://arxiv.org/html/2609.20807 与 https://arxiv.org/html/2609.15987
https://arxiv.org/html/2507.18071
https://arxiv.org/html/2410.02197
https://jasperlu.com/blog/training-search-agents-grpo/
https://emilianopp.github.io/Privileged-Information-Distillation-and-Self-Distillation/
https://zhuanlan.zhihu.com/p/2055665933373421047